LabVIEW 2026 Q3ではNigel AIがコード生成に対応したことがフォーカスされていますが、その裏で日本人ユーザーにとって大きなアップデートがありました。それは…
UTF-8対応
…です。これまでは文字コードがShift-JISの仕様により不都合なことがありましたが、これが解消されたことが期待されます。いろいろ試してみます。
文字列をUTF-8にする方法
フロントパネル、または、ブロックダイアグラムに文字列制御器や文字列定数を置いて右クリックすると、Representationから文字コードを選べます。
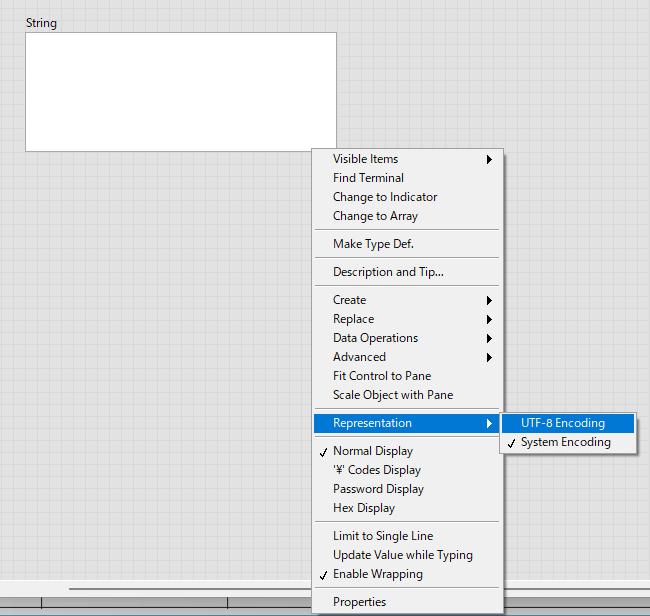
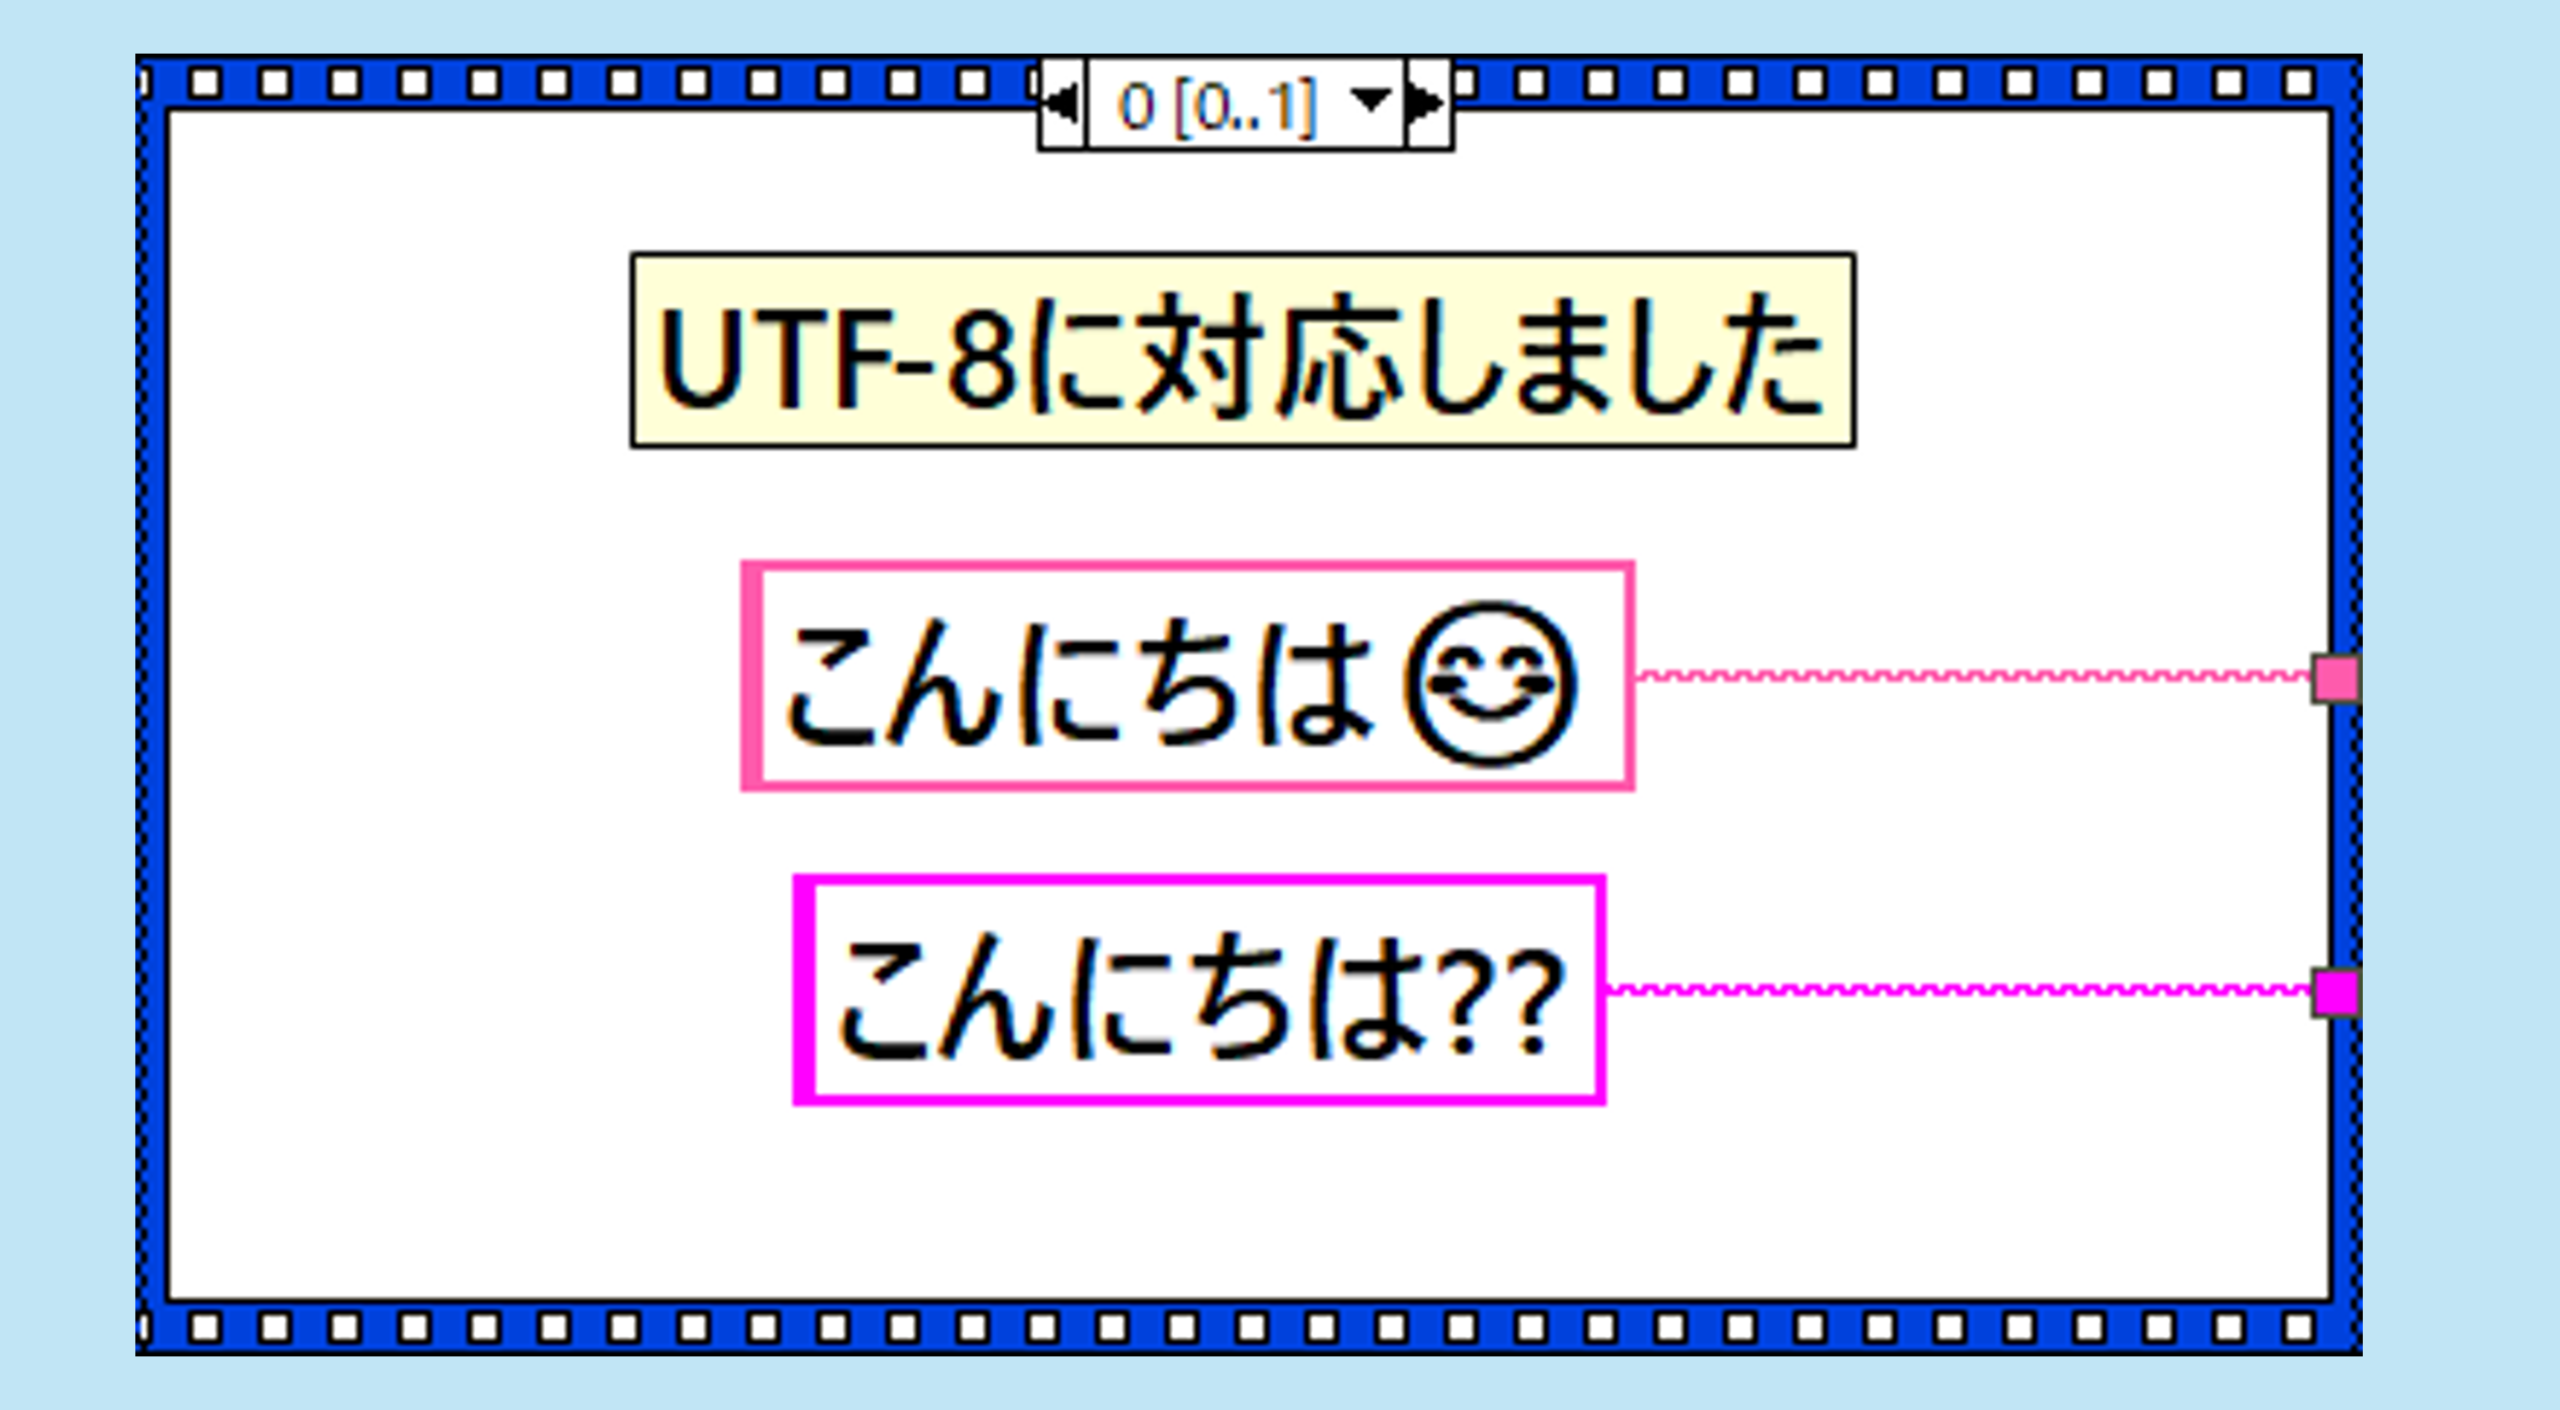
ここでUTF-8 Encodingを選ぶと文字コードをUTF-8にできます。その証拠?にUTF-8では絵文字が使えるようになっています。
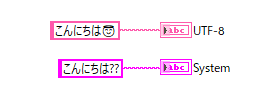
…さすがに絵文字はカラーにならないですね。上がUTF-8で下がこれまでのLabVIEWの文字列です。ブロックダイアグラムをよく見ると、配線の色が少し異なります。これまでの文字列の配線や端子はあざやかなピンク色でしたが、UTF-8では淡いピンク色になっています。文字コードで困る人は日本人ぐらいだと思うので、桜のような和の配線色にしたのでしょう。…知らんけど。
文字列の関数で使えるか?
とりあえず、まずは通常の文字列関数を使えるか試しました。
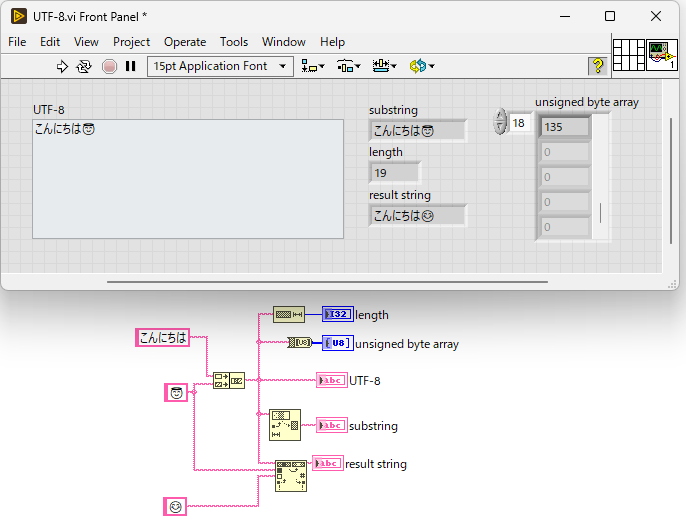
文字列連結や文字列長取得、文字列検索+置換などは問題なくできるようです。使い方もこれまでの文字列の配線と同じでただ配線するだけです。文字列関数で右クリックして…などの操作は必要ないです。すべての文字列関数を試したわけではないですが、たぶん全部使えると思います。
次に、テキストファイルを読み取ってみました。Windows 10からメモ帳で保存するとUTF-8で保存されるのがデフォルト設定になっているので、これが読めるとうれしいです。テキストファイルの読み取り/書き込みも対応する関数で右クリック→Representationから文字コードを選択できます。
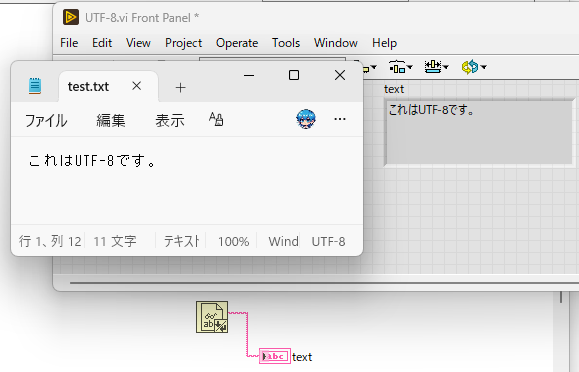
文字化けせずに読み取れています。書き込みもちゃんとできているようです。スプレッドシートの読み取り/書き込みのサブVI(Polymorphic VI)もString UTF-8を選択できるようになっています。これにより、これまで必要だったVIパッケージマネージャーからNI Unicodeをインストールして…というのが不要になります。これはうれしいです。ただし、構成ファイル(Configurationファイル、iniファイル)についてはUTF-8には対応していないので、UTF-8で保存したい場合は変換する必要があります。
文字列のフォーマット/スキャン
文字列のフォーマットはどうでしょうか?Shift-JISには通称ダメ文字と呼ばれる文字があります。この文字が含まれる文字列で文字列のフォーマットなどの処理をやろうとするとコンパイルできなかったりバグったりします。ダメ文字には表、十、構などのよく使う文字も含まれます。なので、コードでShift-JISをできるだけ使いたくなかったのですが、これまでのLabVIEWでは使わないという選択肢がありませんでした。これが今回UTF-8を選択できるようになったことでどうなっているか?試してみました。
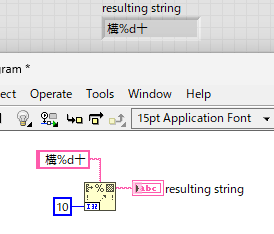
…コンパイルはできました。でも、%dは10に置換されずにそのまま%dと出力されました。うまくいかないですね。
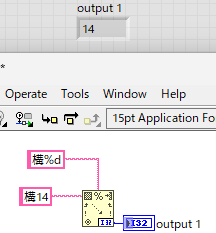
…スキャンはうまくいくんですね。この辺は、今後のアップデートで修正されるかもしれません。というより、してほしいところです。
UTF-8とシステム文字列の変換
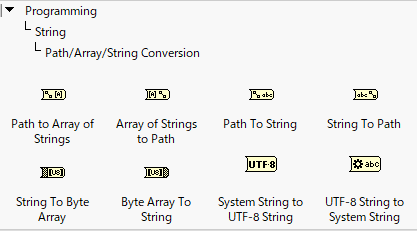
今回のアップデートでUTF-8を使えるようになりましたが、LabVIEWの文字列のデフォルト設定はシステム(Shift-JIS)ですし、すべての文字列を扱う関数で対応しているわけではありません。例えば、UTF-8の文字列をVISAリソースに直接入力することはできませんし、TCP読み取りはシステム文字列しか使えません(TCP書き込みはUTF-8でできる)。なので、こういったときはシステム文字列とUTF-8を変換する関数を使います。これは今回追加された関数で、関数パレットのProgramming → String → Path/Array/String Conversionにあります。
たとえば、こんな感じに使います。
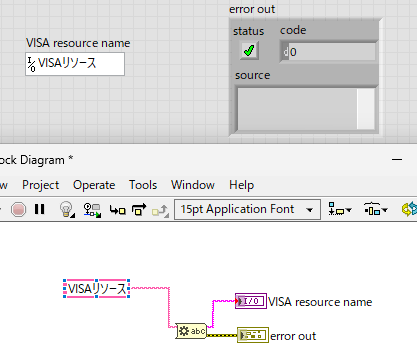
この場合、UTF-8文字列をそのままVISAリソースに配線できそうですが、実際にやると配線が壊れます。なので、変換関数を間に入れます。
追加されたプロパティ
UTF-8対応により、文字列に2つ(たぶん)のプロパティが追加されました。メソッドは追加されていないと思います。
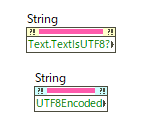
上はテキストがUTF-8か確認するもので、下は文字列がUTF-8でエンコードされているかを見るものです。これだけだと同じですが、両者には次の違いがあります。
- Text→Text is UTF8?:リードオンリー。デフォルト設定で使えるプロパティ。
- UTF-8 Encoded?:書き込み可能であるが、実行中のVIに書き込みはできない。オプションでVI Scriptingを有効にすると使える。
UTF-8 Encoded?はVIをプログラム的に編集することを想定したものです。文字列制御器や定数がたくさんあると手作業でUTF-8に設定するのは大変なので、それらをプログラム的にUTF-8に変更するようなときに使います。文字コードがUTF-8か確認する場合はTextのText is UTF8?を使ったほうがいいかもしれません。
まとめ
今回の文字コードに関するアップデートで次のようになったと思います。
- UTF-8を扱える。絵文字も使える。
- 多くの文字列関数、ファイル関数でUTF-8が使える。使えないものもある。
- UTF-8とシステム文字列を変換する関数が追加された。
- UTF-8か確認するプロパティが追加された。
少し見た感じでは、VISA関係はUTF-8ではコンパイルエラーになるようです。計測器制御のコマンドは通常はアルファベットなので問題ないと言えばないですが。ほかにもHTTPクライアントなど、一部UTF-8の文字列を直接配線できないところはありますが、個人的にはこのアップデートはうれしいと感じています。
追記
文字列以外についても少し試しました。
- テキストリング:UTF-8にはできる。できるがプログラム的に設定するしかなく、簡単ではない。
- 列挙体:UTF-8にはできなさそう。
- ラベル/キャプション:UTF-8にはできなさそう。
- ファイルパス:UTF-8にはできなさそう。
- フリーラベル:UTF-8にできる。右クリックで設定可能。
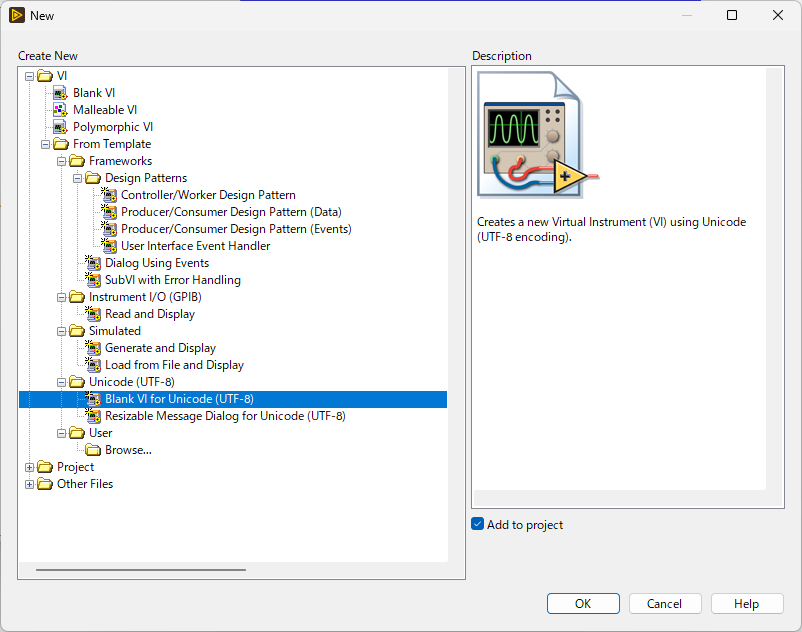
上メニューのFile → NewにあるTempleteからUTF-8の空VIが作れるようです。このVIでは、文字列制御器などを置くとUTF-8になり、テキストリングもUTF-8になるようです。ただ、列挙体の文字列はシステム文字列のようです。
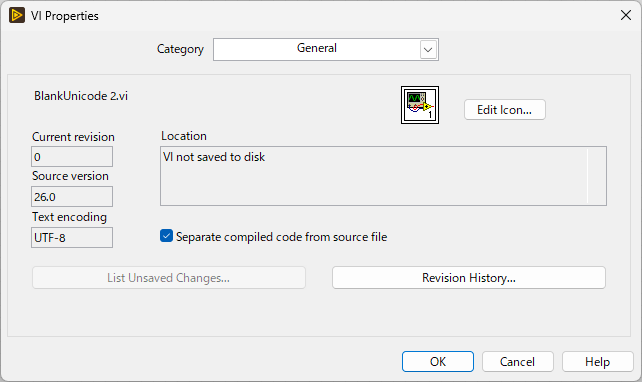
VIプロパティにText encodingというものがあります。これがそのうち対話的に設定可能になるのでしょうか?現時点では謎です。